Ta treść została automatycznie przetłumaczona z ukraińskiego.
Człowiek postrzega świat na wiele sposobów. Możemy oglądać zdjęcie, czytać podpis pod nim, słuchać wyjaśnień i zwracać uwagę na intonację rozmówcy. Wszystkie te źródła informacji uzupełniają się nawzajem i pomagają lepiej zrozumieć sytuację.
Systemy komputerowe przez długi czas działały inaczej: jeden program analizował tekst, inny rozpoznawał obrazy, a trzeci przetwarzał dźwięk. Systemy multimodalne nauczyły się łączyć kilka typów danych w ramach jednego zadania.
Co oznacza słowo „multimodalność”
Multimodalność — to wykorzystanie kilku sposobów przekazywania lub postrzegania informacji. Pierwsza część słowa, multi-, oznacza „wiele”, a modalnością w tym kontekście nazywa się oddzielny format lub kanał informacji.
Do podstawowych modalności należą:
- tekst;
- obrazy;
- mowa i inne dźwięki;
- wideo;
- gesty i ruchy;
- dane przestrzenne i sensoryczne.
Multimodalność istniała na długo przed pojawieniem się nowoczesnej sztucznej inteligencji. Na przykład film łączy wideo, muzykę, mowę i napisy, a podręcznik — tekst pisany, zdjęcia, mapy, tabele i schematy. Prezentację również można nazwać multimodalną, jeśli wystąpienie jest wspierane przez slajdy, wykresy lub nagrania wideo.
Co to jest multimodalna SI
Multimodalna sztuczna inteligencja — to system zdolny do przetwarzania i łączenia informacji różnych typów. Na przykład taki model może otrzymać zdjęcie i pytanie tekstowe, przeanalizować je razem, a następnie sformułować odpowiedź.
Standardowy model tekstowy działa z pisemnymi zapytaniami i wydaje tekstowe wyniki. System widzenia komputerowego może określić, co przedstawia zdjęcie, ale niekoniecznie jest w stanie prowadzić rozmowę na temat tego, co widzi. Model multimodalny łączy różne sposoby pracy z danymi.
Można mu pokazać zdjęcie uszkodzonego urządzenia i zapytać, co oznacza wskaźnik na panelu. System przeanalizuje obraz, spróbuje odczytać widoczne napisy i wyjaśnić problem słowami. Podobnie może przetworzyć wykres, opisać scenę w wideo lub odpowiedzieć na pytanie głosowe.
To zdolność do przyjmowania, łączenia i analizowania tekstu, obrazów, dźwięku, wideo i innych typów danych leży u podstaw multimodalnej SI.
Jak działa multimodalność w SI
Aby komputer mógł porównywać różne modalności, dane muszą zostać przekształcone w numeryczne reprezentacje. Sposób takiego przekształcenia zależy od architektury konkretnego modelu. Tekst, na przykład, może być dzielony na tokeny, a obrazy — na oddzielne obszary lub cechy wizualne. Nagranie dźwiękowe również dzieli się na elementy, na podstawie których system może rozpoznawać mowę i inne cechy dźwięku.
Następnie model ustala powiązania między tymi reprezentacjami. W trakcie uczenia może przyswoić, że pewne kształty i kolory na obrazie odpowiadają słowu „wieloryb”, a konkretny fragment dźwięku oznacza to samo słowo w mowie.
Jednym z głównych zadań takiego systemu jest prawidłowe łączenie powiązanych elementów. Na przykład w wideo należy powiązać słowa z dźwiękiem i odpowiednimi wydarzeniami w kadrze, a podczas analizy dokumentu — powiązać tekst z tabelami, schematami i ilustracjami.
Model multimodalny niekoniecznie działa równie dobrze ze wszystkimi formatami. Jeden system może pewnie analizować teksty i zdjęcia, ale nie obsługiwać wideo. Inny — rozpoznawać mowę i odpowiadać głosem, ale nie tworzyć obrazów.
Dlatego multimodalność nie oznacza, że system potrafi absolutnie wszystko. Wskazuje jedynie na zdolność do pracy przynajmniej z kilkoma typami danych.
Modalności wejściowe i wyjściowe
Podczas opisywania multimodalnej SI ważne jest rozróżnienie informacji, które model otrzymuje, oraz wyniku, który może stworzyć.
Modalności wejściowe — to formaty, które system jest w stanie przyjmować i analizować. Na przykład użytkownik może przesłać zdjęcie i zadać do niego pytanie tekstowe lub głosowe.
Modalności wyjściowe — to formaty, w których model wydaje wynik. Może odpowiedzieć tekstem, wygenerować obraz, wypowiedzieć wiadomość lub stworzyć wideo.
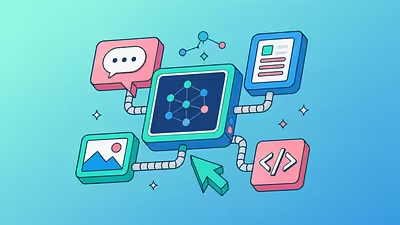
System może być multimodalny tylko na wejściu. Na przykład analizuje tekst i obrazy, ale odpowiada wyłącznie tekstem. Inny model może być multimodalny zarówno na wejściu, jak i na wyjściu: odbierać tekst, dźwięk i zdjęcia, a w odpowiedzi tworzyć tekst, głos lub obrazy. Podobną zasadę — przekształcanie danych jednego typu w wynik innego typu — stosują nowoczesne multimodalne modele.
Jak multimodalna SI różni się od generatywnej
Pojęcia multimodalny i generatywny opisują różne właściwości systemu.
Generatywna SI tworzy nową treść: tekst, obrazy, muzykę, wideo lub kod programowy. Multimodalna SI działa z kilkoma typami danych. Jeden model może mieć obie właściwości, ale te pojęcia nie są synonimami.
Na przykład system, który otrzymuje tekstowy opis i tworzy na jego podstawie obraz, łączy dwie modalności — tekstową i wizualną. Bardziej zaawansowany model może otrzymać zdjęcie pokoju, przeanalizować je, uwzględnić życzenia użytkownika i wygenerować nową wersję wnętrza.
Jednocześnie multimodalny system niekoniecznie musi tworzyć nową treść. Może jedynie analizować wideo razem z dźwiękiem, aby określić, co dzieje się w kadrze.
Gdzie wykorzystuje się systemy multimodalne
Jednym z najbardziej oczywistych przykładów są chatboty, którym można nie tylko zadać pytanie, ale również przesłać zdjęcie, dokument, nagranie audio lub wideo. Jednak zakres zastosowania multimodalnej SI jest znacznie szerszy.
W medycynie takie systemy mogą pomagać w porównywaniu obrazów badań z tekstowymi zapisami lekarzy i innymi danymi pacjenta. W edukacji — wyjaśniać diagramy, analizować wykonane zadania lub opisywać materiały dydaktyczne. W robotyce połączenie danych z kamer, mikrofonów i czujników pomaga maszynom orientować się w przestrzeni.
Technologie multimodalne wykorzystuje się również do tworzenia napisów,
Artykuł był udany pod względem struktury i ogólnie poprawny pod względem faktów. Uściśliłam pochodzenie terminu, uprościłam techniczne wyjaśnienie, usunęłam kilka powtórzeń i dokładniej rozdzieliłam multimodalną i generatywną SI. Oto wersja końcowa.
Co to jest multimodalność i po co jest potrzebna sztucznej inteligencji
Człowiek postrzega świat na wiele sposobów. Możemy oglądać zdjęcie, czytać podpis pod nim, słuchać wyjaśnień i zwracać uwagę na intonację rozmówcy. Wszystkie te źródła informacji uzupełniają się nawzajem i pomagają lepiej zrozumieć sytuację.
Systemy komputerowe przez długi czas działały inaczej: jeden program analizował tekst, inny rozpoznawał obrazy, a trzeci przetwarzał dźwięk. Systemy multimodalne nauczyły się łączyć kilka typów danych w ramach jednego zadania.
Co oznacza słowo „multimodalność”
Multimodalność — to wykorzystanie kilku sposobów przekazywania, postrzegania lub przetwarzania informacji. Pierwsza część słowa, „multi-”, oznacza wielość, a modalnością w tym kontekście nazywa się oddzielny typ lub kanał informacji.
Do podstawowych modalności należą:
- tekst;
- obrazy;
- mowa i inne dźwięki;
- wideo;
- gesty i ruchy;
- dane przestrzenne i sensoryczne.
Multimodalność istniała na długo przed pojawieniem się nowoczesnej sztucznej inteligencji. Na przykład film łączy wideo, muzykę, mowę i napisy, a podręcznik — tekst pisany, zdjęcia, mapy, tabele i schematy. Prezentacja również jest multimodalnym formatem, jeśli wystąpienie jest wspierane przez slajdy, wykresy lub nagrania wideo.
Co to jest multimodalna SI
Multimodalna sztuczna inteligencja — to system zdolny do przetwarzania i łączenia informacji różnych typów. Do takich danych mogą należeć teksty, obrazy, dźwięk, wideo i sygnały z czujników. W ten sposób multimodalna SI definiuje IBM w swoim przeglądzie technologii.
Na przykład model może otrzymać zdjęcie i pytanie tekstowe, przeanalizować je razem, a następnie sformułować odpowiedź. Można mu pokazać zdjęcie uszkodzonego urządzenia i zapytać, co oznacza wskaźnik na panelu. System spróbuje rozpoznać elementy obrazu, odczytać widoczne napisy i wyjaśnić to, co widzi, słowami.
Jednomodalny system działa tylko z jednym typem danych. Na przykład model tekstowy przyjmuje i tworzy tekst, a program rozpoznawania obrazów analizuje zdjęcia. Model multimodalny może łączyć te możliwości.
Jak działa multimodalność w SI
Komputer nie postrzega zdjęcia, frazy ani dźwięku tak jak człowiek. Najpierw różne typy informacji muszą zostać przekształcone w numeryczne reprezentacje, które model może przetwarzać.
Tekst zazwyczaj dzieli się na tokeny — słowa, części słów, znaki interpunkcyjne i inne elementy. Obraz może być dzielony na małe obszary, z których system wydobywa cechy wizualne. Nagranie dźwiękowe również przekształca się w dane numeryczne, które umożliwiają analizę mowy, barwy, wysokości dźwięku i innych cech.
Następnym zadaniem jest ustalenie zgodności między różnymi modalnościami. Na przykład system musi powiązać słowo „wieloryb” z obrazami wielorybów, a pewien fragment nagrania audio — z wymową tego słowa. W bardziej skomplikowanych przypadkach musi powiązać poszczególne momenty wideo z dźwiękami, wypowiedziami lub napisami tekstowymi.
W tym celu mogą być używane specjalizowane komponenty, które najpierw przetwarzają każdy typ danych, a następnie łączą uzyskane informacje. Inne podejście zakłada pracę z różnymi modalnościami w ramach bardziej spójnego modelu. Główne zadanie w obu przypadkach polega nie tylko na przyjęciu kilku formatów, ale także na prawidłowym ustaleniu powiązań między nimi.
Modalności wejściowe i wyjściowe
Podczas opisywania multimodalnej SI ważne jest rozróżnienie informacji, które model otrzymuje, oraz wyniku, który może stworzyć.
Modalności wejściowe — to formaty, które system jest w stanie przyjmować i analizować. Na przykład użytkownik może przesłać zdjęcie i zadać do niego pytanie tekstowe lub głosowe.
Modalności wyjściowe — to formaty, w których model wydaje wynik. Może odpowiedzieć tekstem, wygenerować obraz, wypowiedzieć wiadomość lub stworzyć wideo.
System może być multimodalny tylko na wejściu. Na przykład analizuje tekst i obrazy, ale odpowiada wyłącznie tekstem. Inny model może działać z kilkoma formatami zarówno na wejściu, jak i na wyjściu. Google Cloud również zauważa, że multimodalne modele mogą przyjmować dane jednego typu i przekształcać je w wynik innego typu.
Jednocześnie multimodalność nie oznacza, że system potrafi pracować ze wszystkimi możliwymi formatami. Jeden model może analizować teksty i zdjęcia, ale nie obsługiwać wideo. Inny — rozpoznawać mowę i odpowiadać głosem, ale nie tworzyć obrazów.
Jak multimodalna SI różni się od generatywnej
Pojęcia „multimodalny” i „generatywny” opisują różne właściwości systemu.
Generatywna SI tworzy nową treść: tekst, obrazy, muzykę, wideo lub kod programowy. Multimodalna SI działa z kilkoma typami informacji. Jeden model może mieć obie właściwości, jednak te terminy nie są synonimami.
Na przykład generator obrazów, który przyjmuje tekstowy opis i tworzy na jego podstawie obraz, działa z dwiema modalnościami: tekstową i wizualną. Bardziej zaawansowany system może otrzymać zdjęcie pokoju, uwzględnić życzenia użytkownika i wygenerować nową wersję wnętrza.
Jednocześnie multimodalny system niekoniecznie musi tworzyć nową treść. Może jedynie analizować wideo razem z dźwiękiem, aby określić, co dzieje się w kadrze.
Gdzie wykorzystuje się systemy multimodalne
Jednym z najbardziej oczywistych przykładów są chatboty, którym można nie tylko zadać pytanie, ale również przesłać zdjęcie, dokument, nagranie audio lub wideo. Jednak zakres zastosowania multimodalnej SI jest znacznie szerszy.
W medycynie takie systemy mogą porównywać obrazy badań z tekstowymi zapisami i innymi danymi pacjenta. W edukacji — wyjaśniać diagramy, analizować ręcznie wykonane zadania lub opisywać materiały dydaktyczne. W robotyce połączenie informacji z kamer, mikrofonów i czujników pomaga maszynom orientować się w przestrzeni.
Technologie multimodalne wykorzystuje się również do tworzenia napisów, sterowania głosowego, tłumaczenia mowy, wyszukiwania po obrazach oraz pomocy osobom z zaburzeniami wzroku lub słuchu. Na przykład system może na głos opisać obiekty przed kamerą lub przekształcić mowę ustną w tekst.
Dlaczego multimodalne modele się mylą
Obecność kilku źródeł informacji nie czyni systemu bezbłędnym. Model może błędnie rozpoznać mały napis, pomylić podobne przedmioty, nie uwzględnić kontekstu lub niedokładnie zinterpretować intonację.
Znaczenie ma także jakość materiału. Rozmyte zdjęcie, hałaśliwe nagranie audio, przycięty dokument lub nieprecyzyjnie sformułowane pytanie zwiększają prawdopodobieństwo błędu. Ponadto system może pewnie opisać detal, którego w rzeczywistości nie ma — co prowadzi do swoistej halucynacji SI.
Trudności pojawiają się również wtedy, gdy różne źródła sobie przeczą. Na przykład podpis pod zdjęciem może nie odpowiadać obrazowi, a ścieżka dźwiękowa — nie zgadzać się z wideo. Model musi określić, której informacji zaufać, ale nie zawsze robi to poprawnie.
Dlatego wyniki multimodalnej SI należy weryfikować, szczególnie jeśli chodzi o medycynę, bezpieczeństwo, finanse czy inne dziedziny, w których błąd może mieć poważne konsekwencje.
Multimodalność przybliża interakcję z komputerem do zwykłej ludzkiej komunikacji. Zamiast tłumaczyć wszystko na polecenia tekstowe, użytkownik może pokazać przedmiot, zadać pytanie głosem lub przesłać dokument. System z kolei łączy te sygnały i odpowiada w odpowiednim formacie. To właśnie możliwość pracy nie z jednym izolowanym kanałem, ale z kilkoma rodzajami informacji stanowi istotę multimodalności.