Dieser Inhalt wurde automatisch aus dem Ukrainischen übersetzt.
Der Mensch nimmt die Welt auf mehrere Arten wahr. Wir können ein Foto betrachten, die Beschriftung darunter lesen, Erklärungen anhören und auf die Intonation des Gesprächspartners achten. All diese Informationsquellen ergänzen sich gegenseitig und helfen, die Situation besser zu verstehen.
Computersysteme arbeiteten lange Zeit anders: Ein Programm analysierte Text, ein anderes erkannte Bilder, ein drittes bearbeitete Ton. Multimodale Systeme haben gelernt, mehrere Datentypen innerhalb einer Aufgabe zu kombinieren.
Was bedeutet das Wort „Multimodalität“
Multimodalität ist die Verwendung mehrerer Methoden zur Übertragung oder Wahrnehmung von Informationen. Der erste Teil des Wortes, multi-, bedeutet „viele“, und Modalität bezeichnet in diesem Kontext ein bestimmtes Format oder einen Kanal von Informationen.
Zu den Hauptmodalitäten gehören:
- Text;
- Bild;
- Sprache und andere Geräusche;
- Video;
- Gesten und Bewegungen;
- räumliche und sensorische Daten.
Multimodalität existierte lange vor dem Aufkommen moderner künstlicher Intelligenz. Zum Beispiel kombiniert ein Film Video, Musik, Sprache und Textuntertitel, während ein Lehrbuch geschriebenen Text, Fotos, Karten, Tabellen und Diagramme enthält. Eine Präsentation kann ebenfalls als multimodal bezeichnet werden, wenn der Vortrag von Folien, Grafiken oder Videoaufzeichnungen begleitet wird.
Was ist multimodale KI
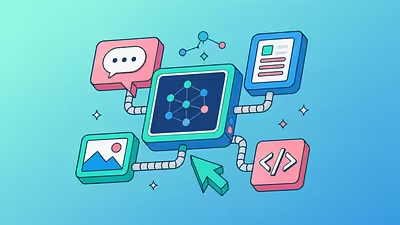
Multimodale künstliche Intelligenz ist ein System, das in der Lage ist, Informationen verschiedener Typen zu verarbeiten und zu kombinieren. Zum Beispiel kann ein solches Modell ein Foto und eine textuelle Frage erhalten, diese gemeinsam analysieren und dann eine Antwort formulieren.
Ein herkömmliches Textmodell arbeitet mit geschriebenen Anfragen und gibt textuelle Ergebnisse aus. Ein System für Computer Vision kann erkennen, was auf einem Foto abgebildet ist, ist aber nicht unbedingt in der Lage, ein Gespräch über das Gesehene zu führen. Ein multimodales Modell kombiniert verschiedene Arten der Datenverarbeitung.
Man kann ihm ein Bild eines defekten Geräts zeigen und fragen, was die Anzeige auf dem Panel bedeutet. Das System analysiert das Bild, versucht, auffällige Beschriftungen zu lesen und das Problem mit Worten zu erklären. Ebenso kann es ein Diagramm bearbeiten, eine Szene in einem Video beschreiben oder auf eine Sprachfrage antworten.
Die Fähigkeit, Text, Bilder, Audio, Video und andere Datentypen zu empfangen, zu kombinieren und zu analysieren, bildet die Grundlage für multimodale KI.
Wie funktioniert Multimodalität in KI
Damit ein Computer verschiedene Modalitäten abgleichen kann, müssen die Daten in numerische Darstellungen umgewandelt werden. Die Art dieser Umwandlung hängt von der Architektur des jeweiligen Modells ab. Text kann zum Beispiel in Tokens zerlegt werden, während Bilder in einzelne Bereiche oder visuelle Merkmale unterteilt werden. Auch eine Audioaufnahme wird in Elemente zerlegt, anhand derer das System Sprache und andere Klangmerkmale erkennen kann.
Das Modell stellt dann Verbindungen zwischen diesen Darstellungen her. Während des Trainings kann es lernen, dass bestimmte Formen und Farben auf einem Bild dem Wort „Wal“ entsprechen, während ein bestimmter Klangfragment dasselbe Wort in gesprochener Sprache bedeutet.
Eine der Hauptaufgaben eines solchen Systems besteht darin, verwandte Elemente korrekt zu kombinieren. Zum Beispiel müssen in einem Video Wörter mit dem Ton und den entsprechenden Ereignissen im Bild abgeglichen werden, während beim Dokumentenanalyse der Text mit Tabellen, Diagrammen und Illustrationen verknüpft werden muss.
Ein multimodales Modell funktioniert nicht unbedingt mit allen Formaten gleich gut. Ein System kann Texte und Fotos sicher analysieren, aber kein Video unterstützen. Ein anderes kann Sprache erkennen und mit Stimme antworten, aber keine Bilder erstellen.
Deshalb bedeutet Multimodalität nicht, dass das System alles kann. Es weist lediglich auf die Fähigkeit hin, mit mindestens mehreren Datentypen zu arbeiten.
Eingangs- und Ausgangsmodalitäten
Bei der Beschreibung multimodaler KI ist es wichtig, zwischen den Informationen, die das Modell erhält, und dem Ergebnis, das es erzeugen kann, zu unterscheiden.
Eingangsmodalitäten sind Formate, die das System akzeptieren und analysieren kann. Zum Beispiel kann der Benutzer ein Foto hochladen und ihm eine textuelle oder sprachliche Frage stellen.
Ausgangsmodalitäten sind Formate, in denen das Modell Ergebnisse ausgibt. Es kann mit Text antworten, Bilder generieren, Nachrichten vorlesen oder Videos erstellen.
Das System kann nur am Eingang multimodal sein. Zum Beispiel analysiert es Text und Bilder, antwortet aber ausschließlich mit Text. Ein anderes Modell kann sowohl am Eingang als auch am Ausgang multimodal sein: es nimmt Text, Ton und Fotos wahr und erzeugt als Antwort Text, Stimme oder Bilder. Ein ähnliches Prinzip — die Umwandlung von Daten eines Typs in das Ergebnis eines anderen Typs — wird von modernen multimodalen Modellen verwendet.
Wie sich multimodale KI von generativer unterscheidet
Die Begriffe multimodal und generativ beschreiben unterschiedliche Eigenschaften eines Systems.
Generative KI erstellt neue Inhalte: Text, Bilder, Musik, Videos oder Programmcode. Multimodale KI arbeitet mit mehreren Datentypen. Ein Modell kann beide Eigenschaften haben, aber diese Begriffe sind keine Synonyme.
Zum Beispiel verbindet ein System, das eine textuelle Beschreibung erhält und daraufhin ein Bild erstellt, zwei Modalitäten — die textliche und die visuelle. Ein komplexeres Modell kann ein Foto eines Raums erhalten, es analysieren, die Wünsche des Benutzers berücksichtigen und eine neue Innenraumvariante generieren.
Gleichzeitig muss ein multimodales System nicht unbedingt neuen Inhalt erstellen. Es kann auch einfach Videos zusammen mit Ton analysieren, um zu bestimmen, was im Bild passiert.
Wo multimodale Systeme eingesetzt werden
Eines der offensichtlichsten Beispiele sind Chatbots, bei denen man nicht nur eine Frage schreiben, sondern auch ein Foto, ein Dokument, eine Audioaufnahme oder ein Video senden kann. Doch der Anwendungsbereich multimodaler KI ist viel breiter.
In der Medizin können solche Systeme helfen, Bilder von Untersuchungen mit den schriftlichen Aufzeichnungen des Arztes und anderen Patientendaten abzugleichen. In der Bildung — Diagramme zu erklären, ausgeführte Aufgaben zu analysieren oder Lernmaterialien zu beschreiben. In der Robotik hilft die Kombination von Daten aus Kameras, Mikrofonen und Sensoren Maschinen, sich im Raum zurechtzufinden.
Multimodale Technologien werden auch zur Erstellung von Untertiteln verwendet,
Der Artikel war strukturell gelungen und insgesamt faktisch korrekt. Ich habe die Herkunft des Begriffs präzisiert, die technische Erklärung vereinfacht, einige Wiederholungen entfernt und multimodale sowie generative KI genauer voneinander abgegrenzt. Hier ist die endgültige Version.
Was ist Multimodalität und warum ist sie für künstliche Intelligenz wichtig
Der Mensch nimmt die Welt auf mehrere Arten wahr. Wir können ein Foto betrachten, die Beschriftung darunter lesen, Erklärungen anhören und auf die Intonation des Gesprächspartners achten. All diese Informationsquellen ergänzen sich gegenseitig und helfen, die Situation besser zu verstehen.
Computersysteme arbeiteten lange Zeit anders: Ein Programm analysierte Text, ein anderes erkannte Bilder, ein drittes bearbeitete Ton. Multimodale Systeme haben gelernt, mehrere Datentypen innerhalb einer Aufgabe zu kombinieren.
Was bedeutet das Wort „Multimodalität“
Multimodalität ist die Verwendung mehrerer Methoden zur Übertragung, Wahrnehmung oder Verarbeitung von Informationen. Der erste Teil des Wortes, „multi-“, bedeutet Vielfalt, und Modalität bezeichnet in diesem Kontext einen bestimmten Typ oder Kanal von Informationen.
Zu den Hauptmodalitäten gehören:
- Text;
- Bild;
- Sprache und andere Geräusche;
- Video;
- Gesten und Bewegungen;
- räumliche und sensorische Daten.
Multimodalität existierte lange vor dem Aufkommen moderner künstlicher Intelligenz. Zum Beispiel kombiniert ein Film Bild, Musik, Sprache und Textuntertitel, während ein Lehrbuch geschriebenen Text, Fotos, Karten, Tabellen und Diagramme enthält. Eine Präsentation ist ebenfalls ein multimodales Format, wenn der Vortrag von Folien, Grafiken oder Videoaufzeichnungen begleitet wird.
Was ist multimodale KI
Multimodale künstliche Intelligenz ist ein System, das in der Lage ist, Informationen verschiedener Typen zu verarbeiten und zu kombinieren. Zu diesen Daten können Texte, Bilder, Ton, Video und Signale von Sensoren gehören. So definiert multimodale KI IBM in seinem Technologiebericht.
Zum Beispiel kann ein Modell ein Foto und eine textuelle Frage erhalten, diese gemeinsam analysieren und dann eine Antwort formulieren. Man kann ihm ein Bild eines defekten Geräts zeigen und fragen, was die Anzeige auf dem Panel bedeutet. Das System wird versuchen, die Elemente des Bildes zu erkennen, auffällige Beschriftungen zu lesen und das Gesehene mit Worten zu erklären.
Ein unimodales System arbeitet nur mit einem Datentyp. Zum Beispiel nimmt ein Textmodell Text auf und erstellt Text, während ein Bildverarbeitungsprogramm Fotos analysiert. Ein multimodales Modell kann diese Möglichkeiten kombinieren.
Wie funktioniert Multimodalität in KI
Ein Computer nimmt ein Foto, einen Satz oder einen Ton nicht so wahr wie ein Mensch. Zunächst müssen verschiedene Informationsarten in numerische Darstellungen umgewandelt werden, die das Modell verarbeiten kann.
Text wird normalerweise in Tokens zerlegt — Wörter, Wortteile, Satzzeichen und andere Elemente. Bilder können in kleine Bereiche unterteilt werden, aus denen das System visuelle Merkmale extrahiert. Auch eine Audioaufnahme wird in numerische Daten umgewandelt, die es ermöglichen, Sprache, Tonhöhe, Klangfarbe und andere Eigenschaften zu analysieren.
Die nächste Aufgabe besteht darin, die Übereinstimmung zwischen verschiedenen Modalitäten herzustellen. Zum Beispiel muss das System das Wort „Wal“ mit Bildern von Walen verknüpfen und ein bestimmtes Fragment der Audioaufnahme mit der Aussprache dieses Wortes. In komplexeren Fällen muss es einzelne Momente eines Videos mit Geräuschen, Dialogen oder Textuntertiteln abgleichen.
Hierfür können spezialisierte Komponenten verwendet werden, die zunächst jeden Datentyp verarbeiten und dann die erhaltenen Informationen kombinieren. Ein anderer Ansatz sieht vor, mit verschiedenen Modalitäten innerhalb eines umfassenderen Modells zu arbeiten. In beiden Fällen besteht die Hauptaufgabe nicht nur darin, mehrere Formate zu akzeptieren, sondern auch die Verbindungen zwischen ihnen korrekt herzustellen.
Eingangs- und Ausgangsmodalitäten
Bei der Beschreibung multimodaler KI ist es wichtig, zwischen den Informationen, die das Modell erhält, und dem Ergebnis, das es erzeugen kann, zu unterscheiden.
Eingangsmodalitäten sind Formate, die das System akzeptieren und analysieren kann. Zum Beispiel kann der Benutzer ein Foto hochladen und ihm eine textuelle oder sprachliche Frage stellen.
Ausgangsmodalitäten sind Formate, in denen das Modell Ergebnisse ausgibt. Es kann mit Text antworten, Bilder generieren, Nachrichten vorlesen oder Videos erstellen.
Das System kann nur am Eingang multimodal sein. Zum Beispiel analysiert es Text und Bilder, antwortet aber ausschließlich mit Text. Ein anderes Modell kann mit mehreren Formaten sowohl am Eingang als auch am Ausgang arbeiten. Google Cloud weist ebenfalls darauf hin, dass multimodale Modelle Daten eines Typs akzeptieren und sie in das Ergebnis eines anderen Typs umwandeln können.
Gleichzeitig bedeutet Multimodalität nicht, dass das System mit allen möglichen Formaten arbeiten kann. Ein Modell kann Texte und Fotos analysieren, aber kein Video unterstützen. Ein anderes kann Sprache erkennen und mit Stimme antworten, jedoch keine Bilder erstellen.
Wie sich multimodale KI von generativer unterscheidet
Die Begriffe „multimodal“ und „generativ“ beschreiben unterschiedliche Eigenschaften eines Systems.
Generative KI erstellt neue Inhalte: Text, Bilder, Musik, Videos oder Programmcode. Multimodale KI arbeitet mit mehreren Datentypen. Ein Modell kann beide Eigenschaften haben, jedoch sind diese Begriffe keine Synonyme.
Zum Beispiel arbeitet ein Bildgenerator, der eine textuelle Beschreibung erhält und daraufhin ein Bild erstellt, mit zwei Modalitäten: der textlichen und der visuellen. Ein komplexeres System kann ein Foto eines Raums erhalten, die vom Benutzer geschriebenen Wünsche berücksichtigen und eine neue Innenraumvariante generieren.
Gleichzeitig muss ein multimodales System nicht unbedingt neuen Inhalt erstellen. Es kann auch einfach Videos zusammen mit Ton analysieren, um zu bestimmen, was im Bild passiert.
Wo multimodale Systeme eingesetzt werden
Eines der offensichtlichsten Beispiele sind Chatbots, bei denen man nicht nur eine Frage schreiben, sondern auch ein Foto, ein Dokument, eine Audioaufnahme oder ein Video senden kann. Doch der Anwendungsbereich multimodaler KI ist viel breiter.
In der Medizin können solche Systeme Bilder von Untersuchungen mit schriftlichen Aufzeichnungen und anderen Patientendaten abgleichen. In der Bildung — Diagramme erklären, handschriftliche Aufgaben analysieren oder Lernmaterialien beschreiben. In der Robotik hilft die Kombination von Informationen aus Kameras, Mikrofonen und Sensoren Maschinen, sich im Raum zurechtzufinden.
Multimodale Technologien werden auch zur Erstellung von Untertiteln, Sprachsteuerung, Übersetzung von Sprache, Bildsuche und Unterstützung von Menschen mit Seh- oder Hörbehinderungen verwendet. Zum Beispiel kann das System Objekte vor der Kamera laut beschreiben oder gesprochene Sprache in Text umwandeln.
Warum multimodale Modelle Fehler machen
Die Anwesenheit mehrerer Informationsquellen macht das System nicht fehlerfrei. Das Modell kann kleine Beschriftungen falsch erkennen, ähnliche Objekte verwechseln, den Kontext nicht berücksichtigen oder die Intonation ungenau interpretieren.
Die Qualität des Materials spielt ebenfalls eine Rolle. Ein verschwommenes Bild, eine rauschende Audioaufnahme, ein abgeschnittenes Dokument oder eine unklar formulierte Frage erhöhen die Wahrscheinlichkeit eines Fehlers. Darüber hinaus kann das System sicher ein Detail beschreiben, das in Wirklichkeit nicht existiert — das heißt, es kann eine Art KI-Halluzination verursachen.
Schwierigkeiten treten auch auf, wenn verschiedene Quellen einander widersprechen. Zum Beispiel kann die Beschriftung unter einem Foto nicht mit dem Bild übereinstimmen, und die Tonspur kann nicht mit dem Video übereinstimmen. Das Modell muss entscheiden, welcher Information es vertrauen kann, tut dies jedoch nicht immer richtig.
Deshalb müssen die Ergebnisse multimodaler KI überprüft werden, insbesondere wenn es um Medizin, Sicherheit, Finanzen oder andere Bereiche geht, in denen Fehler ernsthafte Folgen haben können.
Multimodalität bringt die Interaktion mit dem Computer näher an die gewohnte menschliche Kommunikation. Anstatt alles in Textbefehle zu übersetzen, kann der Benutzer einen Gegenstand zeigen, eine Frage mit Stimme stellen oder ein Dokument senden. Das System wiederum kombiniert diese Signale und antwortet in einem angemessenen Format. Die Fähigkeit, nicht nur mit einem isolierten Kanal, sondern mit mehreren Informationsarten zu arbeiten, ist das Wesen der Multimodalität.