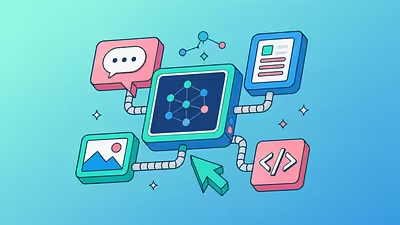
Людина сприймає світ одразу кількома способами. Ми можемо розглядати фотографію, читати підпис під нею, слухати пояснення та звертати увагу на інтонацію співрозмовника. Усі ці джерела інформації доповнюють одне одного й допомагають краще зрозуміти ситуацію.
Комп’ютерні системи тривалий час працювали інакше: одна програма аналізувала текст, інша розпізнавала зображення, третя опрацьовувала звук. Мультимодальні системи навчилися поєднувати кілька типів даних у межах одного завдання.
Що означає слово «мультимодальність»
Мультимодальність — це використання кількох способів передавання або сприйняття інформації. Перша частина слова, мульти-, означає «багато», а модальністю в цьому контексті називають окремий формат або канал інформації.
До основних модальностей належать:
- текст;
- зображення;
- мовлення та інші звуки;
- відео;
- жести й рухи;
- просторові та сенсорні дані.
Мультимодальність існувала задовго до появи сучасного штучного інтелекту. Наприклад, фільм поєднує відео, музику, мовлення і текстові титри, а підручник — написаний текст, фотографії, карти, таблиці та схеми. Презентацію також можна назвати мультимодальною, якщо доповідь супроводжується слайдами, графіками або відеозаписами.
Що таке мультимодальний ШІ
Мультимодальний штучний інтелект — це система, здатна опрацьовувати й поєднувати інформацію кількох типів. Наприклад, така модель може отримати фотографію і текстове запитання, проаналізувати їх разом, а потім сформувати відповідь.
Звичайна текстова модель працює з написаними запитами та видає текстові результати. Система комп’ютерного зору може визначити, що зображено на фотографії, але не обов’язково здатна підтримати розмову про побачене. Мультимодальна модель поєднує різні способи роботи з даними.
Їй можна показати світлину несправного приладу й запитати, що означає індикатор на панелі. Система проаналізує зображення, спробує прочитати помітні написи та пояснити проблему словами. Так само вона може опрацювати графік, описати сцену у відео або відповісти на голосове запитання.
Саме здатність приймати, поєднувати й аналізувати текст, зображення, аудіо, відео та інші типи даних лежить в основі мультимодального ШІ.
Як працює мультимодальність у ШІ
Щоб комп’ютер міг зіставляти різні модальності, дані необхідно перетворити на числові представлення. Спосіб такого перетворення залежить від архітектури конкретної моделі. Текст, наприклад, може розбиватися на токени, а зображення — на окремі ділянки або візуальні ознаки. Звуковий запис також поділяється на елементи, за якими система може розпізнавати мовлення та інші характеристики звуку.
Далі модель установлює зв’язки між цими представленнями. Під час навчання вона може засвоїти, що певні форми й кольори на зображенні відповідають слову «кіт», а конкретний звуковий фрагмент означає те саме слово в усному мовленні.
Одне з головних завдань такої системи — правильно поєднати пов’язані елементи. Наприклад, у відео потрібно зіставити слова зі звуком і відповідними подіями в кадрі, а під час аналізу документа — пов’язати текст із таблицями, схемами та ілюстраціями.
Мультимодальна модель не обов’язково однаково добре працює з усіма форматами. Одна система може впевнено аналізувати тексти й фотографії, але не підтримувати відео. Інша — розпізнавати мовлення та відповідати голосом, проте не створювати зображень.
Тому мультимодальність не означає, що система вміє абсолютно все. Вона лише вказує на здатність працювати щонайменше з кількома типами даних.
Вхідні та вихідні модальності
Під час опису мультимодального ШІ важливо розрізняти інформацію, яку модель отримує, та результат, який вона може створити.
Вхідні модальності — це формати, які система здатна приймати й аналізувати. Наприклад, користувач може завантажити фотографію та поставити до неї текстове або голосове запитання.
Вихідні модальності — це формати, у яких модель видає результат. Вона може відповісти текстом, згенерувати зображення, озвучити повідомлення або створити відео.
Система може бути мультимодальною лише на вході. Наприклад, вона аналізує текст і зображення, але відповідає виключно текстом. Інша модель може бути мультимодальною і на вході, і на виході: сприймати текст, звук та фотографії, а у відповідь створювати текст, голос або зображення. Подібний принцип — перетворення даних одного типу на результат іншого типу — використовують сучасні мультимодальні моделі.
Чим мультимодальний ШІ відрізняється від генеративного
Поняття мультимодальний і генеративний описують різні властивості системи.
Генеративний ШІ створює новий контент: текст, зображення, музику, відео або програмний код. Мультимодальний ШІ працює з кількома типами даних. Одна модель може мати обидві властивості, але ці поняття не є синонімами.
Наприклад, система, яка отримує текстовий опис і створює за ним картинку, пов’язує дві модальності — текстову та візуальну. Складніша модель може отримати фотографію кімнати, проаналізувати її, врахувати побажання користувача й згенерувати новий варіант інтер’єру.
Водночас мультимодальна система не обов’язково має створювати новий контент. Вона може лише аналізувати відео разом зі звуком, щоб визначити, що відбувається в кадрі.
Де використовують мультимодальні системи
Один із найочевидніших прикладів — чат-боти, яким можна не тільки написати запитання, а й надіслати фотографію, документ, аудіозапис або відео. Проте сфера застосування мультимодального ШІ значно ширша.
У медицині такі системи можуть допомагати зіставляти зображення обстежень із текстовими записами лікаря та іншими даними пацієнта. В освіті — пояснювати діаграми, аналізувати виконані завдання або описувати навчальні матеріали. У робототехніці поєднання даних із камер, мікрофонів і датчиків допомагає машинам орієнтуватися в просторі.
Мультимодальні технології також використовують для створення субтитрів,
Стаття була вдалою за структурою та загалом правильною за фактами. Я уточнила походження терміна, спростила технічне пояснення, прибрала кілька повторів і точніше розвела мультимодальний та генеративний ШІ. Ось фінальна версія.
Що таке мультимодальність і навіщо вона потрібна штучному інтелекту
Людина сприймає світ одразу кількома способами. Ми можемо розглядати фотографію, читати підпис під нею, слухати пояснення та звертати увагу на інтонацію співрозмовника. Усі ці джерела інформації доповнюють одне одного й допомагають краще зрозуміти ситуацію.
Комп’ютерні системи тривалий час працювали інакше: одна програма аналізувала текст, інша розпізнавала зображення, третя опрацьовувала звук. Мультимодальні системи навчилися поєднувати кілька типів даних у межах одного завдання.
Що означає слово «мультимодальність»
Мультимодальність — це використання кількох способів передавання, сприйняття або опрацювання інформації. Перша частина слова, «мульти-», означає множинність, а модальністю в цьому контексті називають окремий тип або канал інформації.
До основних модальностей належать:
- текст;
- зображення;
- мовлення та інші звуки;
- відео;
- жести й рухи;
- просторові та сенсорні дані.
Мультимодальність існувала задовго до появи сучасного штучного інтелекту. Наприклад, фільм поєднує відеоряд, музику, мовлення і текстові титри, а підручник — написаний текст, фотографії, карти, таблиці та схеми. Презентація також є мультимодальним форматом, якщо доповідь супроводжується слайдами, графіками або відеозаписами.
Що таке мультимодальний ШІ
Мультимодальний штучний інтелект — це система, здатна опрацьовувати й поєднувати інформацію різних типів. До таких даних можуть належати тексти, зображення, звук, відео та сигнали з датчиків.
Наприклад, модель може отримати фотографію і текстове запитання, проаналізувати їх разом, а потім сформувати відповідь. Їй можна показати світлину несправного приладу й запитати, що означає індикатор на панелі. Система спробує розпізнати елементи зображення, прочитати помітні написи та пояснити побачене словами.
Одномодальна система працює лише з одним типом даних. Наприклад, текстова модель приймає і створює текст, а програма розпізнавання зображень аналізує фотографії. Мультимодальна модель може поєднувати ці можливості.
Як працює мультимодальність у ШІ
Комп’ютер не сприймає фотографію, фразу або звук так само, як людина. Спочатку різні типи інформації потрібно перетворити на числові представлення, які може опрацьовувати модель.
Текст зазвичай розбивається на токени — слова, частини слів, розділові знаки та інші елементи. Зображення може поділятися на невеликі ділянки, з яких система виділяє візуальні ознаки. Звуковий запис також перетворюється на числові дані, що дають змогу аналізувати мовлення, тембр, висоту звуку та інші характеристики.
Наступне завдання — встановити відповідність між різними модальностями. Наприклад, система має пов’язати слово «кіт» із зображеннями котів, а певний фрагмент аудіозапису — з вимовою цього слова. У складніших випадках їй необхідно зіставити окремі моменти відео зі звуками, репліками або текстовими субтитрами.
Для цього можуть використовуватися спеціалізовані компоненти, які спочатку опрацьовують кожен тип даних, а потім об’єднують отриману інформацію. Інший підхід передбачає роботу з різними модальностями в межах більш цілісної моделі. Головне завдання в обох випадках — не просто прийняти кілька форматів, а правильно встановити зв’язки між ними.
Вхідні та вихідні модальності
Під час опису мультимодального ШІ важливо розрізняти інформацію, яку модель отримує, та результат, який вона може створити.
Вхідні модальності — це формати, які система здатна приймати й аналізувати. Наприклад, користувач може завантажити фотографію та поставити до неї текстове або голосове запитання.
Вихідні модальності — це формати, у яких модель видає результат. Вона може відповісти текстом, згенерувати зображення, озвучити повідомлення або створити відео.
Система може бути мультимодальною лише на вході. Наприклад, вона аналізує текст і зображення, але відповідає виключно текстом. Інша модель може працювати з кількома форматами і на вході, і на виході. Мультимодальні моделі можуть приймати дані одного типу та перетворювати їх на результат іншого типу.
Водночас мультимодальність не означає, що система вміє працювати з усіма можливими форматами. Одна модель може аналізувати тексти та фотографії, але не підтримувати відео. Інша — розпізнавати мовлення і відповідати голосом, проте не створювати зображень.
Чим мультимодальний ШІ відрізняється від генеративного
Поняття «мультимодальний» і «генеративний» описують різні властивості системи.
Генеративний ШІ створює новий контент: текст, зображення, музику, відео або програмний код. Мультимодальний ШІ працює з кількома типами інформації. Одна модель може мати обидві властивості, проте ці терміни не є синонімами.
Наприклад, генератор зображень, який приймає текстовий опис і створює за ним картинку, працює з двома модальностями: текстовою та візуальною. Складніша система може отримати фотографію кімнати, врахувати написані користувачем побажання та згенерувати новий варіант інтер’єру.
Водночас мультимодальна система не обов’язково має створювати новий контент. Вона може лише аналізувати відео разом зі звуком, щоб визначити, що відбувається в кадрі.
Де використовують мультимодальні системи
Один із найочевидніших прикладів — чат-боти, яким можна не тільки написати запитання, а й надіслати фотографію, документ, аудіозапис або відео. Проте сфера застосування мультимодального ШІ значно ширша.
У медицині такі системи можуть зіставляти зображення обстежень із текстовими записами та іншими даними пацієнта. В освіті — пояснювати діаграми, аналізувати рукописні завдання або описувати навчальні матеріали. У робототехніці поєднання інформації з камер, мікрофонів і датчиків допомагає машинам орієнтуватися у просторі.
Мультимодальні технології також використовують для створення субтитрів, голосового керування, перекладу мовлення, пошуку за зображенням і допомоги людям із порушеннями зору або слуху. Наприклад, система може вголос описати об’єкти перед камерою або перетворити усне мовлення на текст.
Чому мультимодальні моделі помиляються
Наявність кількох джерел інформації не робить систему безпомилковою. Модель може неправильно розпізнати дрібний напис, переплутати схожі предмети, не врахувати контекст або неточно витлумачити інтонацію.
Значення має і якість матеріалу. Розмите зображення, шумний аудіозапис, обрізаний документ або нечітко сформульоване запитання підвищують імовірність помилки. Крім того, система може впевнено описати деталь, якої насправді немає, — тобто спричинити своєрідну галюцинацію ШІ.
Складнощі виникають і тоді, коли різні джерела суперечать одне одному. Наприклад, підпис під фотографією може не відповідати зображенню, а звукова доріжка — не збігатися з відеорядом. Модель повинна визначити, якій інформації довіряти, але не завжди робить це правильно.
Тому результати мультимодального ШІ потрібно перевіряти, особливо якщо йдеться про медицину, безпеку, фінанси чи інші сфери, де помилка може мати серйозні наслідки.
Мультимодальність наближає взаємодію з комп’ютером до звичного людського спілкування. Замість того щоб переводити все у текстові команди, користувач може показати предмет, поставити запитання голосом або надіслати документ. Система, своєю чергою, поєднує ці сигнали й відповідає у доречному форматі. Саме можливість працювати не з одним ізольованим каналом, а з кількома видами інформації і становить суть мультимодальності.