Dieser Inhalt wurde automatisch aus dem Ukrainischen übersetzt.
Wenn man über ChatGPT und andere große Sprachmodelle spricht, taucht das Wort „Token“ ständig auf. Das Modell hat einen Kontext für eine bestimmte Anzahl von Tokens, die API zählt die eingehenden und ausgehenden Tokens, ein langes Dokument umfasst Zehntausende von Tokens, und ein zu langes Gespräch kann schließlich nicht mehr vollständig in den Kontext passen.
Deshalb ist es leicht vorzustellen, dass ein Token einfach ein technischer Begriff für ein Wort ist. Aber das ist nicht so.
Ein Token ist eine Informationseinheit, in die das System den Text zerlegt, bevor es ihn an das Sprachmodell übergibt.
Ein kurzes Wort kann manchmal ein Token sein, ein längeres mehrere, und auch Satzzeichen, Teile von Wörtern, Zahlen und sogar Fragmente zusammen mit Leerzeichen können zu einzelnen Tokens werden.
Deshalb stimmen die Anzahl der Wörter und die Anzahl der Tokens im Text fast nie überein.
Warum braucht KI überhaupt Tokens
Ein Mensch sieht einen Satz:
„Künstliche Intelligenz hilft, mit Text zu arbeiten“.
Für uns besteht er aus Wörtern und hat eine verständliche Bedeutung. Der Computer hingegen muss letztendlich mit Zahlen arbeiten.
Deshalb gibt es einen zusätzlichen Schritt zwischen menschlichem Text und dem neuronalen Netzwerk — Tokenisierung.
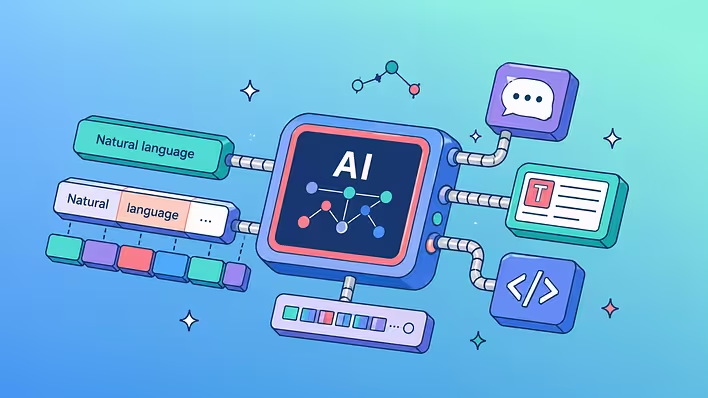
Ein spezielles System, das als Tokenisierer bezeichnet wird, zerlegt den Eingabetext in bestimmte Fragmente. Jedes dieser Fragmente erhält eine numerische Kennung. Diese Zahlenfolge wird dann an das Sprachmodell übergeben.
Der Prozess kann grob so dargestellt werden:
Text → Tokens → numerische IDs → Verarbeitung durch das Modell → neue Tokens → Textantwort
Das heißt, wenn wir ChatGPT eine Frage stellen, erhält das Modell den Satz nicht in der Form, wie wir ihn sehen.
Dies ist eines der grundlegenden Details, ohne das es schwierig ist zu verstehen, wie moderne Sprachmodelle funktionieren.
Ist ein Token ein Wort, ein Buchstabe oder ein Teil eines Wortes?
Es kann alles davon sein.
Frühere Systeme zur Verarbeitung natürlicher Sprache arbeiteten oft mit Wörtern. Dieser Ansatz scheint logisch: Man kann ein Wörterbuch erstellen, in dem jedem Wort eine eigene Nummer zugeordnet ist.
Das Problem tritt fast sofort auf. Es gibt unglaublich viele Sprachen, und die Anzahl der möglichen Wörter ist praktisch unbegrenzt.
Im Ukrainischen beispielsweise können aus dem Wort „працювати“ die Formen „працюю“, „працюєш“, „працювали“, „працюватимемо“ und viele andere abgeleitet werden. Dazu kommen Nachnamen, Firmennamen, Slang, Druckfehler, neue Begriffe, URLs, Programmcode usw.
Wenn man jedes mögliche Wort als separate Einheit behandelt, benötigt man ein riesiges Wörterbuch, das niemals vollständig sein kann.
Die andere Extremität besteht darin, alles in einzelne Zeichen zu zerlegen. Dann wäre das Wörterbuch klein, aber selbst ein kurzer Satz würde in eine sehr lange Sequenz umgewandelt.
Moderne Sprachmodelle verwenden oft einen Kompromiss — Subwort-Tokenisierung. Häufige Wörter oder Fragmente können ganz bleiben, während seltene in kleinere Teile zerlegt werden.
Zum Beispiel kommt die englische Endung -ing so häufig vor, dass sie in BPE-Tokenizern als nützlicher wiederkehrender Bestandteil existieren kann. Genau dieses Prinzip führt OpenAI in der Dokumentation seines tiktoken-Tokenizers an. Gleichzeitig bedeutet „subwort“ hier nicht, dass der Tokenisierer unbedingt echte Wurzeln, Suffixe oder andere Morpheme findet. Die Teilung erfolgt statistisch, und tiktoken verwendet eine Variante von BPE, die mit Bytes arbeitet.
Mit ukrainischen Wörtern geschieht etwas Ähnliches, obwohl die spezifische Teilung vom Tokenisierer abhängt. Dasselbe Wort kann in einem Modell aus zwei Tokens bestehen, in einem anderen aus einem oder drei.
Deshalb kann ein Beispiel wie:
[нейро] [мережа]
das Prinzip gut erklären, bedeutet aber nicht, dass ein bestimmtes Modell das Wort „нейромережа“ genau so zerlegen wird.
Was ist Tokenisierung
Tokenisierung — ist der Prozess der Umwandlung von Rohdaten in eine Sequenz von Tokens, mit der das Modell arbeiten kann.
Für große Sprachmodelle ist es wichtig, einen Teilungsansatz zu finden, der es gleichzeitig ermöglicht, häufige Konstruktionen kompakt darzustellen und nicht bei unbekannten Wörtern verloren zu gehen.
Ein einflussreicher Ansatz war Byte Pair Encoding oder BPE.
Eine große Rolle bei der Verbreitung der Subwort-Tokenisierung in neuronalen Sprachsystemen spielte die 2016 veröffentlichte Arbeit von Rico Sennrich, Barry Haddow und Alexandra Birch „Neural Machine Translation of Rare Words with Subword Units“. Die Forscher zeigten, wie die Teilung in Subwort-Einheiten dem neuronalen maschinellen Übersetzen hilft, mit seltenen und zuvor unbekannten Wörtern zu arbeiten. Dieser Ansatz wurde später äußerst einflussreich für NLP und Systeme wie BERT und GPT.
Vereinfacht gesagt, besteht die Idee darin, dass der Tokenisierer lernt, welche Fragmente häufig in den Daten vorkommen und aus ihnen ein Wörterbuch von Einheiten bildet, die sich gut zur kompakten Darstellung von Text eignen.
Deshalb kann ein beliebtes kurzes Wort ein Token erhalten, während ein seltenes langes Wort in mehrere zerfällt.
Wie ein Token in etwas Verständliches für das Modell umgewandelt wird
Nach der Tokenisierung erhält jeder Token eine bestimmte ID — eine ganze Zahl.
Groß gesagt:
„Wal“ → Token Nr. 18472
„schläft“ → Token Nr. 52931
Diese Nummern dienen nur zur Veranschaulichung des Prinzips — die tatsächlichen IDs hängen vom spezifischen Tokenisierer ab.
Die Nummer selbst enthält keine Bedeutung des Wortes. Token Nr. 18472 ist nicht „katzenartiger“ als Token Nr. 18473 und bedeutet nicht, dass ein Token wichtiger ist als ein anderes. Es ist in erster Linie ein Index, anhand dessen das System die benötigte Darstellung findet.
Dann wird der Token in einen Vektor — eine Menge von Zahlen umgewandelt, die das Modell mathematisch verarbeiten kann. Diese numerische Darstellung wird als Embedding bezeichnet.
Deshalb sind Token und Embedding nicht dasselbe.
Token — die Einheit, in die der Text zerlegt wurde.
Token-ID — ihre Nummer im Wörterbuch.
Embedding — die numerische Darstellung, mit der das neuronale Netzwerk bereits arbeitet.
Hinzu kommt die Information über die Position des Tokens in der Sequenz und andere Mechanismen des Modells. Dann analysiert der Transformer die Beziehungen zwischen den Tokens und bildet eine interne Darstellung des Kontexts.
Wie ChatGPT Text Token für Token generiert
Tokens sind nicht nur zum Lesen der Anfrage erforderlich. Auch die Antwort des Modells wird durch sie erzeugt.
Wenn man es stark vereinfacht, erhält das Sprachmodell bereits eine vorhandene Sequenz und bestimmt die Wahrscheinlichkeiten der möglichen nächsten Tokens.
Zum Beispiel:
„Die Hauptstadt der Ukraine — ...“
Danach bewertet das Modell mögliche Fortsetzungen, und der Generierungsmechanismus bestimmt den nächsten Token.
Wenn er erscheint, wird der Prozess wiederholt:
Kontext → nächster Token → aktualisierter Kontext → nächster Token → ...
So wird allmählich ein Satz, ein Absatz und eine ganze Antwort gebildet.
Natürlich ist ein modernes großes Sprachmodell viel komplexer als eine einfache Wahrscheinlichkeitsmatrix. Es berücksichtigt eine riesige Anzahl von Beziehungen im Kontext, und moderne Systeme können zusätzlich Suchfunktionen, Werkzeuge, Dateiverwaltung und Denkmechanismen nutzen. Aber auf der Ebene der Textgenerierung bleibt das Konzept des Tokens fundamental.
Wie viele Zeichen oder Wörter enthält ein Token
Es gibt keine universelle Formel.
OpenAI gibt für die englische Sprache eine nützliche ungefähre Schätzung an: Ein Token entspricht oft etwa vier Zeichen oder drei Vierteln eines Wortes. Dementsprechend entsprechen 100 Tokens ungefähr 75 englischen Wörtern. Gleichzeitig betont das Unternehmen, dass das Ergebnis von der Sprache, dem Kontext, dem Modell und der Kodierung abhängt.
Hier ist eine wichtige Klarstellung — dieses Formel bezieht sich auf Englisch.
Es ist nicht sinnvoll, ukrainische Texte mechanisch danach zu zählen. Verschiedene Schriftsysteme, Morphologie und wie effektiv ein bestimmter Tokenisierer eine bestimmte Sprache darstellt, beeinflussen die Anzahl der Tokens.
Deshalb ist es nicht zwingend, dass 1000 ukrainische und 1000 englische Wörter die gleiche Anzahl von Tokens belegen.
Darüber hinaus können sogar zwei fast identische Zeilen aufgrund von Großschreibung, Leerzeichen oder Satzzeichen unterschiedlich tokenisiert werden.
Warum Leerzeichen und Satzzeichen auch wichtig sind
Der Tokenisierer arbeitet nicht mit „Begriffen“, sondern mit einer bestimmten Sequenz von Zeichen oder Bytes.
Deshalb:
„Wal“ „wal“ „ wal“und „wal.“
können verschiedene Token-Sets bilden.
In der Dokumentation von OpenAI gibt es ein anschauliches Beispiel mit dem Wort red: Seine Darstellung unterscheidet sich je nach Groß- oder Kleinschreibung, Position im Satz und dem Vorhandensein eines Leerzeichens vor dem Wort.
Das mag wie ein unbedeutendes technisches Detail erscheinen, erklärt aber viele ungewöhnliche Verhaltensweisen von Sprachmodellen.
Warum KI manchmal schlecht Buchstaben in Wörtern zählt
Ein klassisches Beispiel ist, die Sprachmodell zu bitten, die Anzahl bestimmter Buchstaben in einem Wort zu zählen.
Für einen Menschen ist die Aufgabe natürlich: Wir können das Wort Zeichen für Zeichen betrachten. Für das Sprachmodell ist die Anfangseinheit oft nicht ein einzelner Buchstabe, sondern ein Token, das mehrere Zeichen enthalten kann.
Deshalb kann ein Wort, das der Mensch als eine Sequenz von zehn Buchstaben sieht, für das Modell aus mehreren Fragmenten bestehen.
Dies ist einer der Gründe, warum es Sprachmodellen historisch schwerer fiel, bestimmte Aufgaben mit genauem Zählen von Zeichen, Anagrammen oder Manipulationen mit einzelnen Buchstaben zu erfüllen, als Aufgaben, die semantisch viel komplexer erscheinen.
Moderne Systeme können dieses Problem durch Denken, Programmcode oder andere Werkzeuge ausgleichen, sodass die Tokenisierung nicht zwangsläufig bedeutet, dass das Modell einen Fehler macht. Aber sie hilft zu verstehen, woher diese seltsame Schwäche überhaupt kommt.
Was ist ein Kontextfenster und welche Beziehung haben Tokens dazu
Der Begriff „Kontextfenster“ beschreibt das Volumen an Informationen, das das Modell während der Ausführung einer Aufgabe berücksichtigen kann.
Und dieses Volumen wird genau in Tokens gemessen.
In den Kontext können nicht nur die letzte Benutzeranfrage, sondern auch frühere Nachrichten des Gesprächs, systemische Anweisungen, Teile von Dokumenten, Ergebnisse von Werkzeugen und andere Informationen, die für die Antwort erforderlich sind, einfließen.
Groß gesagt, wenn das Modell ein Kontextfenster von 100.000 Tokens hat, bedeutet das nicht, dass der Benutzer genau 100.000 Tokens Text einfügen kann und oben eine unbegrenzte Antwort erhält. In vielen Modellen umfasst das Gesamtlimit sowohl eingehende als auch ausgehende Tokens, und die genauen Einschränkungen hängen vom spezifischen Modell und Dienst ab. Moderne Modelle mit großem Kontext können Hunderttausende von Tokens unterstützen.
Ein großes Kontextfenster bedeutet nicht perfekte Erinnerung
Es gibt eine wichtige Falle: Wenn das Modell technisch in der Lage ist, ein sehr langes Dokument zu erhalten, bedeutet das noch nicht, dass es jeden Teil davon gleich gut nutzen kann.
In einer bekannten Studie „Lost in the Middle: How Language Models Use Long Contexts“ überprüften die Autoren, wie Sprachmodelle relevante Informationen in großen Kontexten finden. In den von ihnen untersuchten Modellen war das Ergebnis oft besser, wenn die relevante Information am Anfang oder Ende des Kontexts lag, und verschlechterte sich, wenn sie sich in der Mitte befand.
Seitdem haben sich langkontextuelle Modelle erheblich weiterentwickelt, daher sollten die Ergebnisse dieser Arbeit nicht automatisch auf jedes moderne Modell übertragen werden. Aber die Unterscheidung zwischen „kann N Tokens aufnehmen“ und „nutzt alle N Tokens gleich gut“ bleibt wichtig.
Deshalb ist es nicht immer besser, gedankenlos Dutzende von Dokumenten in eine Anfrage einzufügen, als einen kleineren, aber relevanten Informationssatz zu übermitteln.
Kontext und Gedächtnis sind verschiedene Dinge
Durch Tokens wird es auch einfacher, den Unterschied zwischen Kontext und KI-Gedächtnis zu verstehen.
Der Kontext ist die Information, die dem Modell direkt während einer bestimmten Anfrage zur Verfügung steht. Man kann sich ihn wie einen Schreibtisch vorstellen: Das Modell sieht, was gerade darauf liegt.
Das Gedächtnis in Produkten wie ChatGPT ist ein separater Mechanismus. Informationen aus früheren Interaktionen können außerhalb des aktuellen Kontexts gespeichert werden, und relevante Informationen können bei Bedarf in zukünftigen Gesprächen verwendet werden.
Das heißt, eine Erhöhung des Kontextfensters allein gibt KI kein endloses Gedächtnis.
Was sind eingehende und ausgehende Tokens
In Entwicklerdiensten sieht man oft die Begriffe input tokens und output tokens.
Eingehende Tokens — die Informationen, die das System dem Modell zur Verarbeitung übergeben hat: die Benutzeranfrage und anderer Kontext.
Ausgehende Tokens — die Tokens, die das Modell in der Antwort erstellt hat.
In einigen APIs gibt es auch andere Kategorien. Zum Beispiel zählt OpenAI separat cachierte Tokens — eingehende Tokens, die aus dem Cache stammen — und Reasoning Tokens, die einige Modelle für interne Schritte vor der Bildung der endgültigen Antwort verwenden. Diese Kategorien werden in den API-Nutzungsdaten angezeigt.
Für einen normalen Benutzer, der ChatGPT über die Website oder die App nutzt, bleiben diese Kategorien größtenteils technische Details. Für einen Entwickler, der über die API arbeitet, beeinflussen sie jedoch direkt die Ressourcennutzung und die Kosten.
Warum für KI oft nach Tokens bezahlt wird
Für APIs großer Sprachmodelle sind Tokens eine bequeme Maßeinheit für die Nutzung geworden.
Eine Anfrage mit zwei Sätzen und die Analyse eines 300-seitigen Dokuments erfordern ganz unterschiedliche Rechenleistungen. Dasselbe gilt für eine kurze Antwort „ja“ und einen detaillierten Bericht von mehreren Tausend Wörtern.
Deshalb legen Anbieter von KI-Diensten oft die Preise je nach Anzahl der verarbeiteten Tokens fest.
In der OpenAI API werden die Tarife für Sprachmodelle unter anderem separat für eingehende, cachierte eingehende und ausgehende Tokens festgelegt, und die Preise werden normalerweise pro Million Tokens angegeben. Die Kosten hängen vom spezifischen Modell ab.
Das sollte nicht mit einem Abonnement für ChatGPT verwechselt werden: Ein Benutzer eines regulären ChatGPT-Tarifs erhält keine separate Rechnung für jedes verwendete Token. Das Token-Modell zur Berechnung ist besonders wichtig für Entwickler, die Sprachmodelle über APIs in ihre eigenen Anwendungen integrieren, sowie für spezifische Unternehmensnutzungspläne.
Warum ein kürzerer Prompt nicht immer besser ist
Wenn Tokens den Kontext und die Kosten beeinflussen, könnte die logische Frage aufkommen: Sollten alle Anfragen so kurz wie möglich gehalten werden?
Nicht unbedingt.
Überflüssige zwanzig Sätze können tatsächlich unnötig sein. Aber eine übermäßig kurze Anfrage könnte den Kontext fehlen, der für eine gute Antwort erforderlich ist.
Zum Beispiel:
„Schreibe einen Brief“.
nimmt sehr wenig Tokens in Anspruch, erklärt dem Modell aber fast nichts.
Im Gegensatz dazu:
„Schreibe einen kurzen freundlichen Brief an einen Kunden, um ihn über die Verschiebung des Treffens von Montag auf Mittwoch zu informieren. Ohne übermäßig formellen Ton“.
wird länger sein, definiert die Aufgabe aber viel präziser.
Deshalb ist die Optimierung von Tokens nicht die Kunst, so wenig wie möglich zu schreiben. Vielmehr ist es die Fähigkeit, keinen Kontext für Informationen zu verschwenden, die nicht zur Erfüllung der Aufgabe beitragen.
Warum verschiedene Modelle denselben Text unterschiedlich zählen
Es gibt keinen universellen Tokenisierer für die gesamte künstliche Intelligenz.
Verschiedene Modellfamilien können unterschiedliche Wörterbücher, Tokenisierungsalgorithmen und Regeln zur Textverarbeitung haben. Selbst innerhalb eines Unternehmens können verschiedene Modellgenerationen eine andere Kodierung verwenden.
OpenAI weist ausdrücklich darauf hin, dass die genaue Anzahl der Tokens vom Modell und der Kodierung abhängt, und stellt eine Bibliothek tiktoken zur Verfügung, um mit der Tokenisierung ihrer Modelle zu arbeiten.
Deshalb ist die Aussage „Dieser Text hat 3000 Tokens“ ohne Angabe des Tokenisierers manchmal nur ungefähr.
Es wäre korrekter zu sagen: „Dieser Text hat ungefähr 3000 Tokens für dieses Modell oder diese Kodierung“.
Was sind spezielle Tokens
Nicht alle Tokens entsprechen unbedingt sichtbaren Teilen des normalen Textes.
Modelle und Systeme um sie herum können spezielle Tokens verwenden, die die Struktur der Informationen kennzeichnen: zum Beispiel die Grenzen bestimmter Fragmente oder Steuerungselemente des Formats. Im tiktoken selbst gibt es auch einen separaten Mechanismus für spezielle Tokens.
Der Benutzer sieht sie normalerweise nicht.
Das ist ein weiterer Grund, warum die Anzahl der Tokens, die tatsächlich an das Modell übergeben werden, nicht immer einfach durch Zählen der Zeichen in der sichtbaren Nachricht bestimmt werden kann.
Gibt es nicht-textuelle Tokens
Ja. In multimodalen Systemen kann das Konzept des Tokens nicht nur auf Text angewendet werden.
Wenn ein Modell mit Bildern, Audio oder anderen Datentypen arbeitet, muss auch diese Information in eine numerische Darstellung umgewandelt werden, die für die Verarbeitung durch das neuronale Netzwerk geeignet ist. Der spezifische Mechanismus hängt von der Architektur ab: Bilder können beispielsweise durch separate Bereiche oder Patches verarbeitet und in eine Sequenz interner Darstellungen umgewandelt werden.
In den modernen OpenAI APIs kann die Verwendung multimodaler Modelle tatsächlich durch separate image tokens, audio tokens und text tokens erfasst werden.
Deshalb bedeutet das Wort „Token“ im weiteren technischen Kontext nicht immer nur ein Stück geschriebenen Wortes. Aber die Art und Weise, wie solche Einheiten für Text, Bilder und Audio gebildet werden, kann ganz unterschiedlich sein, weshalb man sie nicht als denselben Mechanismus betrachten sollte.
Tokens und Modellparameter sind ebenfalls nicht dasselbe
Noch zwei Begriffe, die leicht verwechselt werden können.
Tokens — das sind Informationseinheiten, die das Modell erhält oder generiert.
Parameter — das sind numerische Werte innerhalb des neuronalen Netzwerks, die im Lernprozess gebildet werden.
Wenn gesagt wird, dass das Modell auf Billionen von Tokens trainiert wurde, bezieht sich das auf das Volumen der Trainingsdaten in tokenisierter Form.
Wenn von einem Modell mit Milliarden von Parametern gesprochen wird, ist bereits seine interne Struktur gemeint.
Das heißt, Parameter gehören zum Modell, während Tokens durch es hindurchgehen.
Warum das Konzept des Tokens für den normalen Benutzer wichtig ist
Für ein normales Gespräch mit ChatGPT ist es nicht notwendig, die Tokenisierung zu kennen. Man kann jahrelang KI nutzen, ohne jemals Tokens manuell zu zählen.
Aber genau dieses Konzept erklärt viele Dinge, die sonst seltsam erscheinen.
Warum kann das Modell nicht unendlich die gesamte Gesprächshistorie berücksichtigen? Weil der Kontext eine begrenzte Größe in Tokens hat.
Warum muss ein riesiges Dokument manchmal in Teile zerlegt werden? Weil es in den verfügbaren Kontext passen muss.
Warum kann ein ukrainisches Wort mehr „Platz“ einnehmen als ein ähnliches englisches Wort in der Länge? Weil das Modell nicht mit Wörtern, sondern mit Tokens eines bestimmten Tokenisierers arbeitet.
Warum hat die Nutzung des Sprachmodells über die API unterschiedliche Kosten für kurze und lange Aufgaben? Weil das Volumen der verarbeiteten und generierten Informationen oft in Tokens gemessen wird.
Und selbst der vertraute Satz „KI liest Text“ sieht danach etwas anders aus. Das Sprachmodell sieht die Seite nicht so, wie wir sie sehen. Zuerst wird der Satz in kleine maschinelle Einheiten zerlegt, sie werden in Zahlen und numerische Vektoren umgewandelt, durch das neuronale Netzwerk geleitet — und erst am Ende wird die Sequenz der generierten Tokens wieder zu Wörtern, die auf unserem Bildschirm erscheinen.